• 소득공제
  • 무료배송

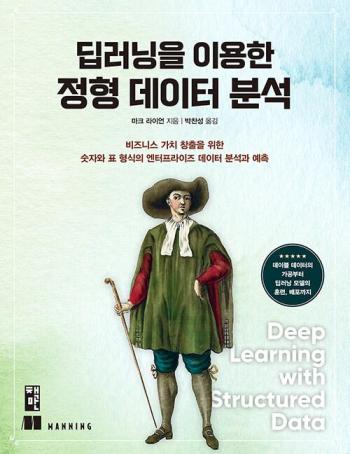
딥러닝을 이용한 정형 데이터 분석 - 비즈니스 가치 창출을 위한 숫자와 표 형식의 엔터프라이즈 데이터 분석과 예측

  • 마크 라이언
  • 박찬성
  • 책만
  • 2022년 06월 20일
사용자 평점
0리뷰 0개
10%25,20028,000원
적립금
1,400원 (5% 적립)
추가 적립 안내
  • 5만원 이상 결제 시 (*배송비 제외)

    정가제FREE(상품/사은품) 금액이
    2,000원 이상이면 2,000원 추가적립

  • 10만원 이상 결제 시 (*배송비 제외)

    정가제FREE(상품/사은품) 금액이
    2,000원 이상이면 2,000원 추가적립

    정가제FREE(상품/사은품) 금액이
    5,000원 이상이면 5,000원 추가적립
회원가입 시 적립금 즉시 지급!

배송비
무료 (해외배송의 경우 지역에 따라 상이)

배송안내

배송비 안내
  • 1만원 이상 주문 시 무료배송 입니다.
  • 주문하신 상품을 해외로 배송 하시는 경우에는 별도의 항공료 가 부과됩니다
서울특별시 강남구 강남대로 542(논현동, 영풍빌딩)
주문 수량 변경시 안내

[주문/배송] 주문 수량 변경 시 안내

주문 수량 변경 시,배송일정이 변경될 수 있으니 반드시 확인해 주시기 바랍니다.
(고객센터 1544-9020)

지금 주문하면 9/28(월) 출고 가능
택배보다 빠른, 나우드림
상품 규격 정보
상품상세정보
ISBNISBN-13 : 9791189909420
쪽수308쪽
크기기타 규격
제품구성단행본
이 책이 속한 분야
  • 컴퓨터/IT > 시스템공학
관련 이벤트

AI추천 이유

책 소개
대부분의 데이터 과학 프로젝트가 완성되기까지, 데이터를 정리해서 모델이 훈련할 수 있는 형식으로 준비하는 데에 절반 이상의 시간이 투입된다는 사실은 모두가 감추는 불편한 진실이다. 하지만 더 나은 방법도 존재한다. 정형 데이터와 관계형 데이터베이스에 최적화된 딥러닝 기법을 사용하면, 피처 엔지니어링을 치열하게 수행하지 않더라도 분석과 통찰을 얻을 수 있다. 데이터 필터링, 검증, 정리 작업은 확 줄이는 한편, 딥러닝 성능을 드높일 수 있는 기술을 이 책에서 배워보자.
이 책에서는 정형 데이터와 관계형 데이터베이스에 대한 강력한 데이터 분석 기법을 알려준다. 현실 세계의 토론토 교통 시스템 데이터셋으로 시작해보자. 배포와 성능 모니터링 등 실제 상용 제품을 만들 때 중요한 고려사항을 해결함은 물론, 정형 데이터셋을 딥러닝에 맞게 구성하는 일이 매우 손쉬워질 것이다. 파이썬과 머신러닝을 이미 알고 있는 독자라면 기량을 드높일 좋은 기회가 될 것이다.

| 이 책의 대상 독자 |
이 책을 최대한 활용하려면 주피터 노트북 환경에서의 파이썬 코딩에 익숙해야만 합니다. 그리고 로지스틱 회귀, 서포트 벡터 머신과 같은 딥러닝 외의 접근법과 머신러닝에서 표준적으로 사용되는 용어에도 익숙한 편이 좋습니다. 만약 행과 열로 구성된 표 형식의 데이터로 작업을 자주 하는 분이라면, 이 책에서 소개한 내용이 여러분의 실제 업무에 쉽게 적용될 수 있다는 사실을 깨닫게 될 것입니다.

목차
1장 정형 데이터를 딥러닝으로 다뤄야 하는 이유
__1.1?딥러닝 개요
__1.2?딥러닝의 장단점
__1.3?딥러닝 소프트웨어 스택
__1.4?정형 데이터와 비정형 데이터
__1.5?정형 데이터에 딥러닝을 사용하는 것에 대한 부정적 시각
__1.6?정형 데이터 문제로 딥러닝을 살펴보는 이유
__1.7?이 책에서 제공하는 코드 소개
__1.8?알아둘 내용
__1.9?정리

2장 판다스 데이터프레임과 책 전반에서 사용할 예제 소개
__2.1?다양한 종류의 딥러닝 개발 환경
__2.2?판다스를 살펴보기 위한 코드
__2.3?파이썬의 판다스 데이터프레임
__2.4?CSV 파일을 판다스 데이터프레임으로 만들기
__2.5?판다스를 사용한 SQL 등의 작업 수행
__2.6?주요 예제: 경전철의 지연 예측
__2.7?딥러닝을 배우는 데 현실의 데이터셋을 사용해야 하는 이유
__2.8?입력 데이터셋의 형식과 범위
__2.9?최종 목표: 엔드투엔드 솔루션
__2.10?솔루션 코드에 대한 상세한 설명
__2.11?개발 환경: 일반적인 환경과 딥러닝이 가능한 환경
__2.12?딥러닝을 배척하는 의견들
__2.13?딥러닝의 접근성이 좋아진 까닭
__2.14?딥러닝 모델 훈련 과정 맛보기
__2.15?정리

3장 데이터 준비 (1) 데이터의 탐색과 정리
__3.1?데이터 탐색 및 정리를 위한 코드
__3.2?파이썬에서 설정 파일을 사용하는 방법
__3.3?XLS 파일을 판다스 데이터프레임으로 변환하기
__3.4?판다스 데이터프레임을 피클링된 파일로 저장하여 세션 간 공유하기
__3.5?데이터 탐색
__3.6?데이터를 연속형, 범주형, 텍스트로 분류하기
__3.7?데이터셋에 내재된 문제 정돈: 누락된 데이터, 오류, 추측성 문제
__3.8?딥러닝에 필요한 데이터 규모의 산정
__3.9?정리

4장 데이터 준비 (2) 데이터 변형
4.1?데이터 준비와 변형을 위한 코드
__4.2?바르지 못한 값 다루기: Route
__4.3?유효하지 않은 값에 대해 하나의 대쳇값만 사용하는 이유
__4.4?올바르지 않은 값 다루기: Vehicle
__4.5?일관성 없는 값 다루기: Location
__4.6?공간 데이터 다루기: Location
__4.7?자료형 불일치 문제 다루기
__4.8?여전히 잘못된 데이터를 가진 행 다루기
__4.9?파생된 열 생성하기
__4.10?딥러닝 모델 훈련을 위해 비수치형 데이터를 수치형 데이터로 대체하는 방법
__4.11?엔드투엔드 솔루션 구성요소
__4.12?정리
__
5장 모델 준비와 구축
__5.1?데이터 누수 및 모델 훈련에 적절한 피처
__5.2?도메인 전문성과 데이터 누수를 방지하기 위한 최소 점수 검정
__5.3?경전철 지연 예측 문제에서 데이터 누수를 방지하는 방안
__5.4?케라스 모델 구축용 코드 살펴보기
__5.5?모델 훈련을 위한 데이터프레임의 단계별 리팩토링
__5.6?케라스 모델이 원하는 형식으로 데이터프레임 변형하기
__5.7?케라스와 텐서플로에 대한 간략한 역사
__5.8?텐서플로 1.x에서 2로 마이그레이션하기
__5.9?텐서플로와 파이토치
__5.10?케라스 딥러닝 모델의 구조
__5.11?데이터 구조가 케라스 모델을 정의하는 방식
__5.12?임베딩 계층의 능력
__5.13?데이터 구조에 따라 자동으로 케라스 모델을 구축하는 코드
__5.14?모델 탐색
__5.15?모델 파라미터
__5.16?정리

6장 모델 훈련과 실험 수행
__6.1?딥러닝 모델 훈련을 위한 코드
__6.2?딥러닝 모델의 훈련 과정 검토
__6.3?경전철 지연 예측용 모델의 최종 목표 검토
__6.4?훈련, 검증, 테스트용 데이터셋 선택
__6.5?초기 훈련 수행
__6.6?모델의 성능 측정
__6.7?케라스 콜백: 훈련 과정 중 최상의 결과를 얻는 방법
__6.8?여러 훈련 과정에서 동일한 결과를 얻는 방법
__6.9?훈련된 모델로 단일 샘플에 대해 예측하기
__6.10?훈련된 모델을 직접 저장하기
__6.11?일련의 실험을 통해 모델 성능 향상하기
__6.12?정리

7장 훈련된 모델로 추가적인 실험 수행
__7.1?더 많은 실험을 수행하기 위한 코드
__7.2?잘못된 값의 제거가 모델 성능을 개선할 수 있는지 검증
__7.3?범주형 열에 적용된 임베딩이 모델 성능을 개선할 수 있는지 검증
__7.4?딥러닝 모델과 XGBoost의 비교
__7.5?딥러닝 모델 개선을 위한 고려사항
__7.6?정리

8장 모델 배포
__8.1?모델 배포의 개요
__8.2?중요한 주제인 배포가 어려운 이유
__8.3?단일 샘플에 대한 모델의 검증 과정 되돌아보기
__8.4?웹 배포에서의 사용자 경험
__8.5?모델을 웹에 배포하기 위한 절차
__8.6?웹 배포의 이면
__8.7?페이스북 메신저 배포에서의 사용자 경험
__8.8?페이스북 메신저 배포의 이면
__8.9?라사에 대한 추가 배경지식
__8.10?모델을 라사로 페이스북 메신저에 배포하기 위한 절차
__8.11?파이프라인의 개요
__8.12?모델 훈련 단계의 파이프라인 정의
__8.13?예측 점수를 매기는 단계에 파이프라인 적용하기
__8.14?배포 후 모델을 유지/보수하는 방법
__8.15?정리

9장 향후 개선 방향
__9.1?지금까지 학습한 내용 되돌아보기
__9.2?경전철 지연 예측 프로젝트 개선을 위한 기본 아이디어
__9.3?상세한 위치 정보 추가 방안
__9.4?딥러닝 모델 훈련을 위한 날씨 데이터 추가 방안
__9.5?딥러닝 학습을 위한 계절 또는 시간대 데이터 파생 방안
__9.6?잘못된 값을 삭제하는 대신 결측값으로 대체하는 대안
__9.7?웹 배포용 모델을 외부에 공개하는 방법
__9.8?새로운 데이터셋에 대한 모델 구축 방안
__9.9?데이터셋 준비와 모델 훈련
__9.10?웹 모델 배포를 위한 코드 변경
__9.11?페이스북 메신저용 모델 배포
__9.12?다른 데이터셋에 적용하기 위한 사례 연구
__9.13?추가 학습 자료
__9.14?정리

부록 A 구글 코랩 가이드
__A.1?코랩이란
__A.2?코랩 세션에서 구글 드라이브 사용하기
__A.3?제공되는 저장소의 노트북을 코랩에서 실행하기
__A.4?코랩과 페이퍼스페이스의 장단점

저자 소개
저자 : 마크 라이언
    마크 라이언
    캐나다 토론토에 위치한 인택트(Intact)라는 보험사의 데이터 과학 매니저다. 머신러닝 부트캠프를 개최해 참가자가 실습을 통해 머신러닝의 세계를 경험하는 기회를 제공하는 등 머신러닝의 유용성을 공유하는 일에 열정적이다. 정형 데이터에 내재된 가치를 찾아내는 딥러닝의 잠재력, 그리고 챗봇과 자율 주행 자동차의 가능성에 관심이 많다. 워털루대학교에서 수학 학사학위를, 토론토대학교에서 컴퓨터 과학 석사학위를 받았다.

    도서리뷰

    이 책을 읽고 어떤 느낌을 받으셨나요?
    리뷰를 남기고 다른 독자들과 함께 공유해보세요.

    안내 열기구매(배송/수령완료) 후 리뷰를 작성하시면 적립금 300원을 드려요!

    등록된 리뷰가 없습니다

    첫번째 리뷰어가 되어주세요

    교환/반품/환불
    반품/교환방법
    • 마이페이지 > 주문관리 > 주문/배송조회 > 주문조회 후  [1:1상담신청]  또는 고객센터 (1544-9020)
    • ※ 오픈마켓, 해외배송 주문상품 문의 시 [1:1상담신청] 또는 고객센터 (1544-9020)
    반품/교환 가능기간
    • 변심반품의 경우 수령 후 7일 이내
    • 상품의 결함 및 계약내용과 다를 경우 문제점 발견 후 30일 이내
    반품/교환비용
    • 단순변심 혹은 구매착오로 인한 반품/교환은 반송료 고객 부담
    • 해외직배송 도서 구매 후 단순변심에 의한 취소 및 반품 시 도서판매가의 20% 수수료 부과
    반품/교환 불가 사유
    • 소비자의 책임 있는 사유로 상품 등이 손실 또는 훼손된 경우
    • 소비자의 사용, 포장 개봉에 의해 상품 등의 가치가 현저히 감소한 경우
      예) 만화, 잡지, 수험서 및 문제집류
    • 복제가 가능한 상품 등의 포장을 훼손한 경우
      예) 음반/DVD/비디오, 소프트웨어, 만화책, 잡지, 영상 화보집
    • 소비자의 요청에 따라 개별적으로 주문 제작되는 상품의 경우
    • 디지털 컨텐츠인 eBook, 오디오북 등을 1회 이상 다운로드를 받았을 경우
    • 시간의 경과에 의해 재판매가 곤란한 정도로 가치가 현저히 감소한 경우
    • 전자상거래 등에서의 소비자보호에 관한 법률이 정하는 소비자 청약철회 제한 내용에 해당되는 경우
    상품 품절
    • 공급사(출판사) 재고 사정에 의해 품절/지연될 수 있으며, 품절 시 관련 사항에 대해서는 이메일과 문자로 안내드리겠습니다.
    소비자 피해보상
    환불지연에 따른 배상
    • 상품의 불량에 의한 교환, A/S, 환불, 품질보증 및 피해보상 등에 관한 사항은 소비자분쟁 해결 기준 (공정거래위원회 고시)에 준하여 처리됨
    • 대금 환불 및 환불지연에 따른 배상금 지급 조건, 절차 등은 전자상거래 등에서의 소비자 보호에 관한 법률에 따라 처리함

    매장에서 사용할 수 있는 바코드가 있어요!