• 베스트
  • 소득공제
  • 무료배송
  • 절판

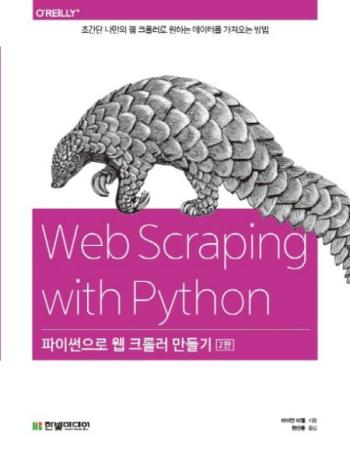
파이썬으로 웹 크롤러 만들기(2판)

  • 라이언미첼
  • 한선용
  • 한빛미디어
  • 2019년 03월 29일
사용자 평점
0리뷰 0개
10%22,50025,000원
적립금
1,250원 (5% 적립)
추가 적립 안내
  • 5만원 이상 결제 시 (*배송비 제외)

    정가제FREE(상품/사은품) 금액이
    2,000원 이상이면 2,000원 추가적립

  • 10만원 이상 결제 시 (*배송비 제외)

    정가제FREE(상품/사은품) 금액이
    2,000원 이상이면 2,000원 추가적립

    정가제FREE(상품/사은품) 금액이
    5,000원 이상이면 5,000원 추가적립
회원가입 시 적립금 즉시 지급!

배송비
무료 (해외배송의 경우 지역에 따라 상이)

배송안내

배송비 안내
  • 1만원 이상 주문 시 무료배송 입니다.
  • 주문하신 상품을 해외로 배송 하시는 경우에는 별도의 항공료 가 부과됩니다
서울특별시 강남구 강남대로 542(논현동, 영풍빌딩)
주문 수량 변경시 안내

[주문/배송] 주문 수량 변경 시 안내

주문 수량 변경 시,배송일정이 변경될 수 있으니 반드시 확인해 주시기 바랍니다.
(고객센터 1544-9020)

택배보다 빠른, 나우드림
상품 규격 정보
상품상세정보
ISBNISBN-13 : 9791162241639
쪽수356쪽
크기B5(188mm X 257mm, 사륙배판)
제품구성단행본
이 책이 속한 분야
  • 컴퓨터/IT > 인터넷
관련 이벤트

AI추천 이유

책 소개
웹 어디서든 내가 원하는 데이터를 쏙쏙쏙 웹에 존재한다면 그것이 어떤 형태이든 데이터로 추출할 수 있다. 필요한 무기는 이 책과 파이썬뿐. BeautifulSoup, 셀레니움, 테서랙트 등 강력한 파이썬 라이브러리 사용법과 함께 API, 인증, 이미지 및 텍스트 인식, 로그인 처리 등 웹 크롤링의 기초부터 고급 기법까지 종합적으로 다루는 유일한 책. 실제 업무와 생활에 적용할 수 있는 예제가 가득하다. 2판은 예제를 추가 및 업데이트했고 모던 웹에서 거의 모든 종류의 데이터를 가져오는 방법을 포괄적으로 다룬다.
목차
Part I 스크레이퍼 제작 CHAPTER 1 첫 번째 웹 스크레이퍼 1.1 연결 1.2 BeautifulSoup 소개 __1.2.1 BeautifulSoup 설치 __1.2.2 BeautifulSoup 실행 __1.2.3 신뢰할 수 있는 연결과 예외 처리 CHAPTER 2 고급 HTML 분석 2.1 닭 잡는 데 소 잡는 칼을 쓸 필요는 없습니다 2.2 다시 BeautifulSoup __2.2.1 find()와 findAll() __2.2.2 다른 BeautifulSoup 객체 __2.2.3 트리 이동 2.3 정규 표현식 2.4 정규 표현식과 BeautifulSoup 2.5 속성에 접근하기 2.6 람다 표현식 CHAPTER 3 크롤링 시작하기 3.1 단일 도메인 내의 이동 3.2 전체 사이트 크롤링 __3.2.1 전체 사이트에서 데이터 수집 3.3 인터넷 크롤링 CHAPTER 4 웹 크롤링 모델 4.1 객체 계획 및 정의 4.2 다양한 웹사이트 레이아웃 다루기 4.3 크롤러 구성 __4.3.1 검색을 통한 사이트 크롤링 __4.3.2 링크를 통한 사이트 크롤링 __4.3.3 여러 페이지 유형 크롤링 4.4 웹 크롤러 모델에 대한 생각 CHAPTER 5 스크레이피 5.1 스크레이피 설치 __5.1.1 새 스파이더 초기화 5.2 간단한 스크레이퍼 작성하기 5.3 규칙에 의한 스파이더링 5.4 항목 만들기 5.5 항목 출력하기 5.6 파이프라인 5.7 스크레이피 로깅 5.8 더 읽을 거리 CHAPTER 6 데이터 저장 6.1 미디어 파일 6.2 데이터를 CSV로 저장 6.3 MySQL __6.3.1 MySQL 설치 __6.3.2 기본 명령어 __6.3.3 파이썬과 통합 __6.3.4 데이터베이스 테크닉과 모범 사례 __6.3.5 여섯 다리와 MySQL 6.4 이메일 Part II 고급 스크레이핑 CHAPTER 7 문서 읽기 7.1 문서 인코딩 7.2 텍스트 __7.2.1 텍스트 인코딩과 인터넷 7.3 CSV __7.3.1 CSV 파일 읽기 7.4 PDF 7.5 마이크로소프트 워드와 .docx CHAPTER 8 지저분한 데이터 정리하기 8.1 코드에서 정리 8.2 사후 정리 __8.2.1 오픈리파인 CHAPTER 9 자연어 읽고 쓰기 9.1 데이터 요약 9.2 마르코프 모델 __9.2.1 위키백과의 여섯 다리: 결론 9.3 자연어 툴킷 __9.3.1 설치 __9.3.2 NLTK를 사용한 통계적 분석 __9.3.3 NLTK를 사용한 사전적 분석 9.4 추가 자료 CHAPTER 10 폼과 로그인 뚫기 10.1 파이썬 requests 라이브러리 10.2 기본적인 폼 전송 10.3 라디오 버튼, 체크박스, 기타 필드 10.4 파일과 이미지 전송 10.5 로그인과 쿠키 처리 __10.5.1 HTTP 기본 접근 인증 10.6 기타 폼 문제 CHAPTER 11 자바스크립트 스크레이핑 __11.1.1 널리 쓰이는 자바스크립트 라이브러리 11.2 Ajax와 DHTML __11.2.1 셀레니움으로 파이썬에서 자바스크립트 실행 __11.2.2 그 밖의 셀레니움 웹드라이버 11.3 리다이렉트 처리 11.4 자바스크립트에 대한 마지막 노트 CHAPTER 12 API를 통한 크롤링 12.1 API에 대한 간단한 소개 __12.1.1 HTTP 메서드와 API __12.1.2 API 응답에 대해 12.2 JSON 파싱 12.3 문서화되지 않은 API __12.3.1 문서화되지 않은 API 찾기 __12.3.2 문서화되지 않은 API 문서화하기 __12.3.3 API 자동으로 찾고 문서화하기 12.4 API와 다른 데이터 소스의 결합 12.5 마치며 CHAPTER 13 이미지 처리와 텍스트 인식 13.1 라이브러리 개관 __13.1.1 필로 __13.1.2 테서랙트 __13.1.3 파이테서랙트 __13.1.4 넘파이 13.2 형식이 일정한 텍스트 처리 __13.2.1 이미지 자동 조정 __13.2.2 웹사이트 이미지에서 텍스트 스크레이핑하기 13.3 CAPTCHA 읽기와 테서랙트 훈련 __13.3.1 테서랙트 훈련 13.4 CAPTCHA 가져오기와 답 보내기 CHAPTER 14 스크레이핑 함정 피하기 14.1 스크레이핑의 윤리에 관해 14.2 사람처럼 보이기 __14.2.1 헤더를 수정하십시오 __14.2.2 쿠키 처리 __14.2.3 타이밍이 가장 중요합니다 14.3 널리 쓰이는 폼 보안 기능 __14.3.1 숨긴 필드 값 __14.3.2 허니팟 피하기 14.4 사람처럼 보이기 위한 체크리스트 CHAPTER 15 스크레이퍼로 웹사이트 테스트하기 15.1 테스트 입문 __15.1.1 단위 테스트란? 15.2 파이썬 unittest __15.2.1 위키백과 테스트 15.3 셀레니움을 사용한 테스트 __15.3.1 사이트 조작 15.4 unittest vs 셀레니움 CHAPTER 16 병렬 웹 크롤링 16.1 프로세스 vs. 스레드 16.2 멀티스레드 크롤링 __16.2.1 경쟁 상태와 큐 __16.2.2 threading 모듈 16.3 멀티프로세스 크롤링 __16.3.1 멀티프로세스 크롤링 __16.3.2 프로세스 간 통신 16.4 멀티프로세스 크롤링의 다른 접근법 CHAPTER 17 원격 스크레이핑 17.1 원격 서버를 쓰는 이유 __17.1.1 IP 주소 차단 방지 __17.1.2 이동성과 확장성 17.2 토어 __17.2.1 파이삭스 17.3 원격 호스팅 __17.3.1 웹사이트 호스팅 계정에서 실행 __17.3.2 클라우드에서 실행 17.4 추가 자료 CHAPTER 18 웹 스크레이핑의 합법성과 윤리 18.1 상표? 저작권? 특허? __18.1.1 저작권법 18.2 동산 침해 18.3 컴퓨터 사기와 악용에 관한 법률 18.4 robots.txt와 이용 약관 18.5 세 가지 웹 스크레이퍼 사례 __18.5.1 이베이 vs. 비더스 에지: 동산 침해 __18.5.2 미국 vs. 오언하이머: 컴퓨터 사기와 악용에 관한 법률 __18.5.3 필드 vs. 구글: 저작권과 robots.txt 18.6 미래를 향해
저자 소개
저자 : 라이언미첼
    라이언 미첼 Ryan Mitchell
    웹 크롤링, 보안, 데이터 과학에 관심이 많은 개발자. 현재 글로벌 펀드사 헤지서브(HedgeServ)에서 시니어 개발자로 근무하고 있습니다. 프랭클린 W. 올린 공과대학교를 졸업했고 하버드 대학교에서 소프트웨어 엔지니어링 석사 과정을 밟았습니다. 어바인(Abine)에서 웹 크롤러와 봇을 만들었고, 링크드라이브(LinkeDrive)에서는 API 및 데이터 분석 도구를 만들었습니다. 금융업 및 유통업 분야에서 웹 크롤링 프로젝트 컨설팅을 하고 있고, 교육과 강연 활동도 활발하게 펼치고 있습니다. 본서 외 저서로 『Instant Web Scraping with Java』(Packt, 2013)가 있습니다.
    도서리뷰

    이 책을 읽고 어떤 느낌을 받으셨나요?
    리뷰를 남기고 다른 독자들과 함께 공유해보세요.

    안내 열기구매(배송/수령완료) 후 리뷰를 작성하시면 적립금 300원을 드려요!

    등록된 리뷰가 없습니다

    첫번째 리뷰어가 되어주세요

    교환/반품/환불
    반품/교환방법
    • 마이페이지 > 주문관리 > 주문/배송조회 > 주문조회 후  [1:1상담신청]  또는 고객센터 (1544-9020)
    • ※ 오픈마켓, 해외배송 주문상품 문의 시 [1:1상담신청] 또는 고객센터 (1544-9020)
    반품/교환 가능기간
    • 변심반품의 경우 수령 후 7일 이내
    • 상품의 결함 및 계약내용과 다를 경우 문제점 발견 후 30일 이내
    반품/교환비용
    • 단순변심 혹은 구매착오로 인한 반품/교환은 반송료 고객 부담
    • 해외직배송 도서 구매 후 단순변심에 의한 취소 및 반품 시 도서판매가의 20% 수수료 부과
    반품/교환 불가 사유
    • 소비자의 책임 있는 사유로 상품 등이 손실 또는 훼손된 경우
    • 소비자의 사용, 포장 개봉에 의해 상품 등의 가치가 현저히 감소한 경우
      예) 만화, 잡지, 수험서 및 문제집류
    • 복제가 가능한 상품 등의 포장을 훼손한 경우
      예) 음반/DVD/비디오, 소프트웨어, 만화책, 잡지, 영상 화보집
    • 소비자의 요청에 따라 개별적으로 주문 제작되는 상품의 경우
    • 디지털 컨텐츠인 eBook, 오디오북 등을 1회 이상 다운로드를 받았을 경우
    • 시간의 경과에 의해 재판매가 곤란한 정도로 가치가 현저히 감소한 경우
    • 전자상거래 등에서의 소비자보호에 관한 법률이 정하는 소비자 청약철회 제한 내용에 해당되는 경우
    상품 품절
    • 공급사(출판사) 재고 사정에 의해 품절/지연될 수 있으며, 품절 시 관련 사항에 대해서는 이메일과 문자로 안내드리겠습니다.
    소비자 피해보상
    환불지연에 따른 배상
    • 상품의 불량에 의한 교환, A/S, 환불, 품질보증 및 피해보상 등에 관한 사항은 소비자분쟁 해결 기준 (공정거래위원회 고시)에 준하여 처리됨
    • 대금 환불 및 환불지연에 따른 배상금 지급 조건, 절차 등은 전자상거래 등에서의 소비자 보호에 관한 법률에 따라 처리함

    매장에서 사용할 수 있는 바코드가 있어요!