• 베스트
  • 소득공제
  • 무료배송
  • 절판

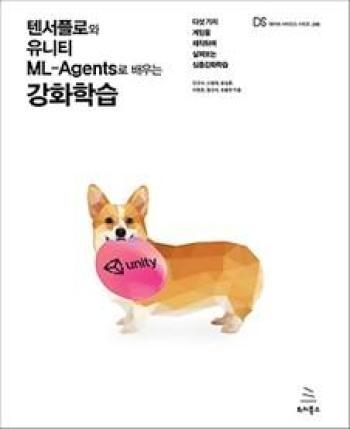
텐서플로와 유니티 ML-AGENTS로 배우는 강화학습(데이터 사이언스 시리즈 46)

  • 민규식외
  • 위키북스
  • 2020년 01월 02일
사용자 평점
0리뷰 0개
10%32,400원36,000원
적립금
1,800원 (5% 적립)
추가 적립 안내
  • 5만원 이상 결제 시 (*배송비 제외)

    정가제FREE(상품/사은품) 금액이
    2,000원 이상이면 2,000원 추가적립

  • 10만원 이상 결제 시 (*배송비 제외)

    정가제FREE(상품/사은품) 금액이
    2,000원 이상이면 2,000원 추가적립

    정가제FREE(상품/사은품) 금액이
    5,000원 이상이면 5,000원 추가적립
회원가입 시 적립금 즉시 지급!

배송비
무료 (해외배송의 경우 지역에 따라 상이)

배송안내

배송비 안내
  • 1만원 이상 주문 시 무료배송 입니다.
  • 주문하신 상품을 해외로 배송 하시는 경우에는 별도의 항공료 가 부과됩니다
서울특별시 강남구 강남대로 542(논현동, 영풍빌딩)
주문 수량 변경시 안내

[주문/배송] 주문 수량 변경 시 안내

주문 수량 변경 시,배송일정이 변경될 수 있으니 반드시 확인해 주시기 바랍니다.
(고객센터 1544-9020)

택배보다 빠른, 나우드림
상품 규격 정보
상품상세정보
ISBNISBN-13 : 9791158391430
쪽수548쪽
크기B5(188mm X 257mm, 사륙배판)
제품구성단행본
이 책이 속한 분야
  • 컴퓨터/IT > 인터넷
관련 이벤트

AI추천 이유

책 소개
강화학습 환경을 제작하고 심층강화학습 알고리즘까지 직접 구현한다! 알파고 이후 강화학습이 많은 사람들에게 관심을 받기 시작했다. 더불어 직접 시뮬레이션 환경을 제작하여 강화학습을 접목하고자 하는 사람도 많아지고 있다. 이를 위해 게임 엔진 회사인 유니티에서 ML-Agents라는 툴을 오픈소스로 공개했다. 하지만 이는 딥러닝, 강화학습, 유니티, ML-Agents 모두에 대한 전반적인 지식을 필요로 했다. 지금까지는 이 모든 지식을 다루는 참고 자료가 부족했기 때문에 ML-Agents에 대한 사용이 어려웠다. 이에 따라 본서는 딥러닝, 강화학습, 유니티, ML-Agents 모든 내용을 다루는 참고 자료로 AI를 잘 모르는 게임 개발자, 게임 개발을 잘 모르는 AI 개발자 그리고 둘 다 모르는 초보 개발자 모두를 위한 책이다.
목차
00장: 강화학습과 딥러닝 개요 0.1 강화학습의 개요 ___0.1.1 기계 학습이란? ___0.1.2 강화학습의 성과 ___0.1.3 강화학습의 기본 용어 ___0.1.4 탐험(Exploration)과 이용(Exploitation) 0.2 인공 신경망 이론 ___0.2.1 인공 신경망(Artificial Neural Network, ANN) ___0.2.2 인공 신경망의 학습 ___0.2.3 데이터 세트의 구성 ___0.2.4 오버피팅(Overfitting)과 언더피팅(Underfitting) ___0.2.5 텐서플로(TensorFlow) ___0.2.6 텐서보드(TensorBoard) 0.3 인공 신경망 코드 ___0.3.1 분류와 회귀 ___0.3.2 회귀 문제(Boston Housing) 0.4 합성곱 신경망 이론 ___0.4.1 합성곱(Convolution) ___0.4.2 합성곱 연산과 관련된 주요 용어 ___0.4.3 합성곱 신경망의 구조 0.5 합성곱 신경망 코드 ___0.5.1 분류 문제(MNIST 데이터 세트) 01장: 유니티와 ML-Agents의 개요 1.1 유니티 설치 및 기초 ___1.1.1 유니티 시작하기 ___1.1.2 유니티 인터페이스 1.2 유니티 ML-Agents ___1.2.1 에이전트(Agent) ___1.2.2 브레인(Brain) ___1.2.3 아카데미(Academy) 02장: ML-Agents 맛보기 2.1 ML-Agents 프로젝트 설정 ___2.1.1 유니티 ML-Agents 내려받기 ___2.1.2 새로운 프로젝트 생성 ___2.1.3 ML-Agents 폴더를 유니티로 복사 ___2.1.4 프로젝트 설정 2.2 유니티 예제 열기 ___2.2.1 3DBall 환경 열기 ___2.2.2 브레인 변경 ___2.2.3 3DBall 환경 빌드 2.3 mlagents 설치 및 학습 ___2.3.1 mlagents 설치 및 경로 설정 ___2.3.2 Getting-started.ipynb 실행 및 코드 설명 ___2.3.3 mlagents를 이용한 학습 ___2.3.4 학습된 결과 테스트 03장: 소코반 환경 만들기 3.1 그리드월드와 소코반 3.2 소코반 폴더 생성 및 파일명 변경 3.3 그리드월드와 소코반 비교 3.4 박스 프리팹 제작 3.5 Academy 스크립트 수정 ___3.5.1 InitializeAcademy() 함수 ___3.5.2 SetEnvironment() 함수 ___3.5.3 AcademyReset() 함수 3.6 Agent 코드 수정 3.7 소코반 환경 플레이 3.8 소코반 환경 빌드 04장: Deep Q Network 4.1 DQN 알고리즘의 개요 4.2 DQN 알고리즘의 기법 ___4.2.1 경험 리플레이(Experience Replay) ___4.2.2 타겟 네트워크(Target Network) 4.3 DQN 학습 4.4 DQN 코드 ___4.4.1 라이브러리 불러오기 및 파라미터 값 설정 ___4.4.2 Model 클래스 ___4.4.3 Agent 클래스 ___4.4.4 Main 함수 ___4.4.5 텐서보드를 이용한 성능 확인 05장: 드론 환경 만들기 5.1 드론 환경 5.2 드론 폴더 생성 및 파일명 변경 5.3 에셋 스토어에서 드론 에셋 내려받기 5.4 드론 에셋 환경 설정 및 플레이 5.5 드론 환경 제작하기 5.6 Agent 코드 작성 ___5.6.1 전역변수 설정 ___5.6.2 InitializeAgent 함수 ___5.6.3 CollectObservations 함수 ___5.6.4 AgentAction 함수(행동 설정) ___5.6.5 AgentAction 함수(보상 설정) ___5.6.6 AgentReset 함수 5.7 플레이어 브레인 설정 및 드론 환경 플레이 5.8 러닝 브레인 설정 및 드론 환경 빌드 06장: Deep Deterministic Policy Gradient 6.1 DDPG 알고리즘의 개요 6.2 DDPG 알고리즘의 기법들 ___6.2.1 경험 리플레이(Experience Replay) ___6.2.2 타겟 네트워크(Target Network) ___6.2.3 소프트 타겟 업데이트(Soft Target Update) ___6.2.4 OU 노이즈(Ornstien Uhlenbeck Noise) 6.3 DDPG 학습 ___6.3.1 크리틱 네트워크 업데이트 ___6.3.2 액터 네트워크 업데이트 6.4 DDPG 코드 ___6.4.1 라이브러리 불러오기 및 파라미터 값 설정 ___6.4.2 OU 노이즈 클래스 ___6.4.3 Actor & Critic 클래스 ___6.4.4 Agent 클래스 ___6.4.5 Main 함수 ___6.4.6 텐서보드를 이용한 성능 확인 07장: 퐁 환경 만들기 7.1 퐁 환경 설명 7.2 퐁 환경 폴더 생성 및 파일명 변경 7.3 퐁 환경 오브젝트 만들기 ___7.3.1 게임판 만들기 ___7.3.2 골대 만들기 ___7.3.3 에이전트 만들기 7.4 오브젝트에 마찰 및 탄성력 적용 7.5 스크립트 제작 ___7.5.1 PongAgent 스크립트 ___7.5.2 PongGoalDetection 스크립트 ___7.5.3 PongAcademy 스크립트 7.6 브레인 추가하기 ___7.6.1 다수의 브레인을 이용한 멀티에이전트 환경 설정 ___7.6.2 하나의 브레인을 이용한 멀티에이전트 환경 설정 7.7 퐁 환경 빌드 08장: 적대적인 DQN 에이전트 만들기 8.1 적대적인 DQN 알고리즘의 개요 8.2 적대적인 DQN 알고리즘 코드 ___8.2.1 라이브러리 불러오기 및 파라미터 값 설정 ___8.2.2 Model 클래스 ___8.2.3 Agent 클래스 ___8.2.4 Main 함수 8.3 하나의 브레인을 이용한 적대적인 DQN 알고리즘 코드 8.4 적대적인 DQN 학습 결과 09장: 소코반 커리큘럼 학습 9.1 커리큘럼 학습이란? 9.2 커리큘럼 학습을 위한 소코반 환경 ___9.2.1 소코반 커리큘럼의 환경 설정 변경 ___9.2.2 Academy 코드 수정 ___9.2.3 Agent 코드 수정 9.3 DDDQN 알고리즘 이론 ___9.3.1 Double DQN ___9.3.2 Dueling DQN 9.4 DDDQN의 학습 코드 작성 ___9.4.1 라이브러리 불러오기 ___9.4.2 파라미터 설정 ___9.4.3 DDDQN_Model 클래스 ___9.4.4 DDDQN_Agent 클래스 ___9.4.5 Main 함수 9.5 소코반 커리큘럼 학습 실행 및 결과 10장: 닷지 환경 만들기 10.1 닷지 환경 소개 10.2 닷지 폴더 생성 및 파일명 변경 10.3 씬 내부의 오브젝트 설정 ___10.3.1 아카데미 스크립트 교체 ___10.3.2 닷지 게임 환경 만들기 ___10.3.3 닷지 에이전트 만들기 ___10.3.4 공 만들기 10.4 스크립트 구성하기 ___10.4.1 DodgeAcademy 스크립트 ___10.4.2 DodgeAgent 스크립트 ___10.4.3 BallScript 스크립트 10.5 브레인 추가 10.6 환경 빌드 10.7 사람의 플레이 데이터 저장하기 ___10.7.1 Demonstration 추가 ___10.7.2 게임 실행 및 학습 데이터 녹화 ___10.7.3 녹화 데이터 저장 경로 11장: Behavioral Cloning 11.1 Behavioral Cloning 알고리즘의 개요 11.2 Behavioral Cloning 알고리즘의 기법 ___11.2.1 보상이 음수인 데이터 제외하기 ___11.2.2 드롭아웃(Dropout) 11.3 Behavioral Cloning 학습 11.4 Behavioral Cloning 코드 ___11.4.1 라이브러리 불러오기 ___11.4.2 파라미터 값 설정 ___11.4.3 Model 클래스 ___11.4.4 Agent 클래스 ___11.4.5 Main 함수 11.5 ml-agents의 내장 Behavioral Cloning 12장: 마무리 12.1 정리 12.2 여러 개의 ML-Agents 환경 동시에 실행하기
저자 소개
저자 : 민규식외
    민규식
    한양대학교에서 기계공학을 전공하고 현재 한양대학교 대학원에서 석박사 통합 과정 중에 있다. 강화학습 관련 페이스북 페이지인 Reinforcement Learning Korea의 운영진으로 활동하고 있으며 유니티 코리아에서 공인한 유니티 전문가 그룹인 Unity Masters로 선정되었다. Unity ML-Agents를 이용하여 다양한 강화학습 환경을 제작하고 있으며 이를 이용하여 연구 및 논문 작성을 수행 중이다. 유니티에서 주관한 1st ML-Agents Challenge에서 Creative Award를 수상했다.

    신명재
    중앙대학교 컴퓨터 공학과 석사를 졸업했다. 현재 고려대학교 전기전자 공학부 Artificial Intelligence and Mobility Lab에서 서울대 의대와 강화학습 기반의 Medical Application 연구를 진행중이다.
    도서리뷰

    이 책을 읽고 어떤 느낌을 받으셨나요?
    리뷰를 남기고 다른 독자들과 함께 공유해보세요.

    안내 열기구매(배송/수령완료) 후 리뷰를 작성하시면 적립금 300원을 드려요!

    등록된 리뷰가 없습니다

    첫번째 리뷰어가 되어주세요

    교환/반품/환불
    반품/교환방법
    • 마이페이지 > 주문관리 > 주문/배송조회 > 주문조회 후  [1:1상담신청]  또는 고객센터 (1544-9020)
    • ※ 오픈마켓, 해외배송 주문상품 문의 시 [1:1상담신청] 또는 고객센터 (1544-9020)
    반품/교환 가능기간
    • 변심반품의 경우 수령 후 7일 이내
    • 상품의 결함 및 계약내용과 다를 경우 문제점 발견 후 30일 이내
    반품/교환비용
    • 단순변심 혹은 구매착오로 인한 반품/교환은 반송료 고객 부담
    • 해외직배송 도서 구매 후 단순변심에 의한 취소 및 반품 시 도서판매가의 20% 수수료 부과
    반품/교환 불가 사유
    • 소비자의 책임 있는 사유로 상품 등이 손실 또는 훼손된 경우
    • 소비자의 사용, 포장 개봉에 의해 상품 등의 가치가 현저히 감소한 경우
      예) 만화, 잡지, 수험서 및 문제집류
    • 복제가 가능한 상품 등의 포장을 훼손한 경우
      예) 음반/DVD/비디오, 소프트웨어, 만화책, 잡지, 영상 화보집
    • 소비자의 요청에 따라 개별적으로 주문 제작되는 상품의 경우
    • 디지털 컨텐츠인 eBook, 오디오북 등을 1회 이상 다운로드를 받았을 경우
    • 시간의 경과에 의해 재판매가 곤란한 정도로 가치가 현저히 감소한 경우
    • 전자상거래 등에서의 소비자보호에 관한 법률이 정하는 소비자 청약철회 제한 내용에 해당되는 경우
    상품 품절
    • 공급사(출판사) 재고 사정에 의해 품절/지연될 수 있으며, 품절 시 관련 사항에 대해서는 이메일과 문자로 안내드리겠습니다.
    소비자 피해보상
    환불지연에 따른 배상
    • 상품의 불량에 의한 교환, A/S, 환불, 품질보증 및 피해보상 등에 관한 사항은 소비자분쟁 해결 기준 (공정거래위원회 고시)에 준하여 처리됨
    • 대금 환불 및 환불지연에 따른 배상금 지급 조건, 절차 등은 전자상거래 등에서의 소비자 보호에 관한 법률에 따라 처리함

    매장에서 사용할 수 있는 바코드가 있어요!