[목 차]
옮긴이 머리말 xi
베타리더 후기 xiii
시작하며 xvi
감사의 글 xxii
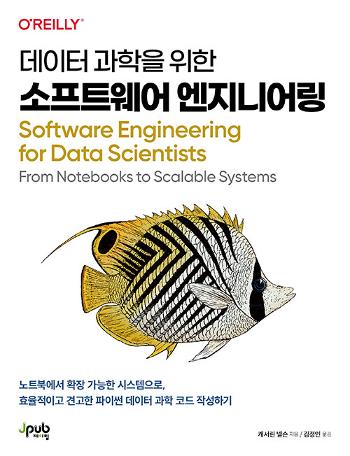
표지에 대하여 xxiii
CHAPTER 1 좋은 코드란 무엇인가? 1
1.1 좋은 코드가 왜 중요한가? 2
1.2 변화하는 요구사항에 대응하기 3
1.3 간결성 3
__1.3.1 같은 일을 반복하지 말라(DRY 원칙) 5
__1.3.2 장황한 코드를 피하라 6
1.4 모듈성 7
1.5 가독성 9
__1.5.1 표준과 규칙 9
__1.5.2 이름 10
__1.5.3 코드 정리 11
__1.5.4 문서화 11
1.6 성능 12
1.7 안정성 12
__1.7.1 오류와 로깅 13
__1.7.2 테스트 13
1.8 요약 14
CHAPTER 2 코드 성능 분석 17
2.1 성능 개선 기법 18
2.2 코드 시간 측정 20
2.3 코드 프로파일링 23
__2.3.1 cProfile 23
__2.3.2 line_profiler 26
__2.3.3 Memray를 활용한 메모리 프로파일링 27
2.4 시간 복잡도 30
__2.4.1 시간 복잡도 추정 방법 30
__2.4.2 빅오 표기법 31
2.5 요약 34
CHAPTER 3 데이터 구조를 효율적으로 사용하기 35
3.1 파이썬 기본 데이터 구조 36
__3.1.1 리스트 36
__3.1.2 튜플 39
__3.1.3 딕셔너리 39
__3.1.4 집합 41
3.2 넘파이 배열 43
__3.2.1 넘파이 배열 기능 43
__3.2.2 넘파이 배열의 성능 고려사항 44
__3.2.3 대스크를 사용한 배열 연산 48
__3.2.4 머신러닝에서의 배열 50
3.3 팬더스 데이터프레임 51
__3.3.1 데이터프레임 기능 52
__3.3.2 데이터프레임의 성능 고려 사항 53
3.4 요약 55
CHAPTER 4 객체지향 프로그래밍과 함수형 프로그래밍 57
4.1 객체지향 프로그래밍 58
__4.1.1 클래스, 메서드, 속성 58
__4.1.2 직접 클래스 정의하기 61
__4.1.3 OOP 원리 64
4.2 함수형 프로그래밍 68
__4.2.1 람다 함수와 map() 69
__4.2.2 함수를 데이터프레임에 적용하기 70
4.3 어떤 패러다임을 사용할 것인가? 71
4.4 요약 72
CHAPTER 5 오류, 로깅, 디버깅 73
5.1 파이썬에서의 오류 73
__5.1.1 파이썬 오류 메시지 읽기 74
__5.1.2 오류 처리 75
__5.1.3 오류 일으키기 79
5.2 로깅 81
__5.2.1 무엇을 로깅할 것인가? 81
__5.2.2 로깅 설정 82
__5.2.3 로그 남기는 방법 83
5.3 디버깅 85
__5.3.1 디버깅 전략 86
__5.3.2 디버깅 도구 87
5.4 요약 93
CHAPTER 6 코드 포매팅, 린팅, 타입 검사 95
6.1 코드 포매팅과 스타일 가이드 96
__6.1.1 PEP8 97
__6.1.2 임포트 포매팅 98
__6.1.3 블랙을 사용해 자동으로 코드 포매팅하기 100
6.2 린팅 102
__6.2.1 린팅 도구 103
__6.2.2 IDE에서 린팅하기 106
6.3 타입 검사 107
__6.3.1 타입 주석 108
__6.3.2 mypy로 타입 검사하기 110
6.4 요약 111
CHAPTER 7 코드 테스트 113
7.1 왜 테스트를 작성해야 하는가? 114
7.2 언제 테스트할까? 115
7.3 테스트 작성 및 실행 방법 116
__7.3.1 기본 테스트 116
__7.3.2 예상치 못한 입력 테스트 118
__7.3.3 Pytest로 자동화된 테스트 실행하기 120
7.4 테스트 종류 123
__7.4.1 단위 테스트 123
__7.4.2 통합 테스트 124
7.5 데이터 검증 125
__7.5.1 데이터 검증 예제 125
__7.5.2 Pandera를 사용해 데이터 검증하기 126
__7.5.3 Pydantic을 이용한 데이터 검증 128
7.6 머신러닝을 위한 테스트 130
__7.6.1 모델 학습 테스트 131
__7.6.2 모델 추론 테스트 131
7.7 요약 132
CHAPTER 8 설계와 리팩터링 133
8.1 프로젝트 설계와 구조 134
__8.1.1 프로젝트 설계 시 고려사항 134
__8.1.2 머신러닝 프로젝트 예제 136
8.2 코드 설계 138
__8.2.1 모듈식 코드 139
__8.2.2 코드 설계 프레임워크 140
__8.2.3 인터페이스와 계약 141
__8.2.4 결합도 141
8.3 노트북을 확장성 있는 스크립트로 144
__8.3.1 왜 노트북 대신 스크립트를 사용하는가? 144
__8.3.2 노트북에서 스크립트 생성하기 145
8.4 리팩터링 148
__8.4.1 리팩터링 전략 149
__8.4.2 리팩터링 작업 예제 150
8.5 요약 152
CHAPTER 9 문서화 153
9.1 코드베이스 내에서의 문서 154
__9.1.1 이름 155
__9.1.2 주석 157
__9.1.3 독스트링 159
__9.1.4 Readme, 튜토리얼, 기타 장문의 문서 162
9.2 주피터 노트북에서의 문서화 163
9.3 머신러닝 실험에 대해 문서화하기 165
9.4 요약 167
CHAPTER 10 코드 공유: 버전 관리, 종속성, 패키징 169
10.1 깃을 사용한 버전 관리 170
__10.1.1 깃의 작동 방식 171
__10.1.2 변경사항 추적 및 커밋 172
__10.1.3 원격과 로컬 174
__10.1.4 브랜치와 풀 리퀘스트 175
10.2 종속성과 가상 환경 179
__10.2.1 가상 환경 180
__10.2.2 pip를 사용한 종속성 관리 182
__10.2.3 Poetry를 사용한 종속성 관리 183
10.3 파이썬 패키징 185
__10.3.1 패키징 기초 186
__10.3.2 pyproject.toml 188
__10.3.3 패키지 빌드 및 업로드 189
10.4 요약 191
CHAPTER 11 API 193
11.1 API 호출 194
__11.1.1 HTTP 메서드와 상태 코드 194
__11.1.2 SDG API에서 데이터 받아오기 195
11.2 FastAPI를 사용해 API 생성하기 199
__11.2.1 API 구성 200
__11.2.2 API에 기능 추가하기 203
__11.2.3 API에 요청하기 207
11.3 요약 209
CHAPTER 12 자동화 및 배포 211
12.1 코드 배포 212
12.2 자동화 예제 213
__12.2.1 프리-커밋 훅 214
__12.2.2 깃허브 액션 217
12.3 클라우드 배포 222
__12.3.1 컨테이너와 도커 223
__12.3.2 도커 컨테이너 구축 223
__12.3.3 구글 클라우드에 API 배포하기 226
__12.3.4 다른 클라우드에 API 배포하기 228
12.4 요약 228
CHAPTER 13 보안 231
13.1 보안이란 무엇인가? 231
13.2 보안 위험 233
__13.2.1 자격 증명, 물리적 보안, 사회공학적 기법 234
__13.2.2 타사 패키지 234
__13.2.3 파이썬 pickle 모듈 235
__13.2.4 버전 관리 위험 235
__13.2.5 API 보안 위험 236
13.3 보안 수칙 236
__13.3.1 보안 리뷰 및 정책 236
__13.3.2 보안 코딩 도구 237
__13.3.3 간단한 코드 스캔 238
13.4 머신러닝을 위한 보안 241
__13.4.1 ML 시스템 공격 241
__13.4.2 ML 시스템에서의 보안 수칙 243
13.5 요약 244
CHAPTER 14 소프트웨어 업계에서 일하기 247
14.1 개발 원칙 및 실전 247
__14.1.1 소프트웨어 개발 생애주기 247
__14.1.2 폭포수 소프트웨어 개발 방법론 249
__14.1.3 애자일 소프트웨어 개발 방법론 249
__14.1.4 애자일 데이터 과학 250
14.2 소프트웨어 업계에서의 역할 251
__14.2.1 소프트웨어 엔지니어 251
__14.2.2 QA 혹은 테스트 엔지니어 253
__14.2.3 데이터 엔지니어 254
__14.2.4 데이터 분석가 254
__14.2.5 제품 관리자 255
__14.2.6 UX 연구원 256
__14.2.7 디자이너 257
14.3 커뮤니티 258
__14.3.1 오픈소스 258
__14.3.2 이벤트에서 연설하기 260
__14.3.3 파이썬 커뮤니티 261
14.4 요약 262
CHAPTER 15 다음 단계 265
15.1 코드의 미래 267
15.2 코드에 담긴 당신의 미래 270
15.3 감사의 말 270
찾아보기 272
[본 문]
코드를 작성하는 것은 완벽하게 설계되고 계획이 확정된 다음 건설에 들어가는 다리를 건설하는 것과는 다르다. 데이터 과학 프로젝트 등에서 코드를 작성할 때 변하지 않는 한 가지 원칙은 프로젝트를 수행하는 동안 변경사항이 발생할 수 있다는 점을 예상해야 한다는 것이다. (…) 적응력은 코드베이스가 커질수록 더 중요해진다. 소규모 스크립트 하나라면 변경사항을 반영하기 간단하다. 그렇지만 프로젝트 규모가 커지고 여러 스크립트나 노트북으로 나뉘어 서로 의존하는 형태를 갖게 되면 변경하기 더 복잡하고 어려워질 수 있다. 처음부터 코드를 잘 짜두면 큰 프로젝트에서 코드를 수정하기 쉬워질 것이다. (3쪽)
리스트에 요소를 추가할 때마다 메모리에서 추가 공간을 차지한다. 파이썬은 원래 리스트 길이보다 여유 있게 메모리 공간을 할당하지만 이 공간이 가득 차면 전체 리스트는 연속된 공간을 더 확보할 수 있는 새로운 메모리 위치로 복사되어야 한다. 리스트의 마지막에 요소를 추가하는 것은 O(1)의 복잡도를 갖지만 추가 할당된 공간까지 가득 차면 리스트를 복사해야 하므로 약간의 오버헤드가 수반된다. (…) 리스트에 특정 길이까지 요소가 추가될 것을 안다면 .append()가 가장 효율적인 방법은 아닐 것이다. 리스트 컴프리헨션(list comprehension)을 사용하거나 초깃값으로 0을 채운 정확한 길이의 리스트를 생성한 다음 값을 업데이트하는 것이 더 나을 것이다. 리스트의 시작과 마지막에 아이템을 추가하고자 한다면 collections 모듈의 양방향큐 deque 데이터 구조를 사용할 수 있다. (37~38쪽)
다형성(polymorphism)은 서로 다른 클래스에 대해 동일한 인터페이스를 가질 수 있어 코드를 단순화하고 반복을 줄일 수 있음을 뜻한다. 즉, 두 개의 클래스가 유사한 결과를 만들지만 내부 동작은 서로 다른 같은 이름의 메서드를 가질 수 있다. 이 두 개의 클래스는 부모와 자식 클래스일 수도 있고 서로 아무 관계가 없을 수도 있다. / 사이킷런은 다형성의 대표적인 예다. 모든 분류기는 다른 클래스로 정의되었더라도, 특정 데이터에 분류기를 훈련시키는 fit이라는 같은 이름의 메서드가 있다. 다음은 특정 데이터에 두 개의 서로 다른 분류기를 훈련시키는 예제다. (67쪽)
Pydantic을 사용하면 실행 시간에 데이터를 검증할 수 있다. 이 도구는 파이썬 커뮤니티에서 점점 인기를 얻고 있는 믿을 수 없을 만큼 유용한 라이브러리다. Pydantic은 데이터를 검증하기 위해 6.3절에서 소개했던 타입 주석을 사용한다. 그렇지만 mypy처럼 정적 분석 도구는 아니다. 대신 코드를 실행할 때 검증하기 때문에 별도의 도구를 실행시킬 필요가 없다. 이는 코드를 API에 배포할 경우 특히 유용하다. (…) Pydantic은 데이터를 검증하기 위해 데이터 스키마 개념을 사용한다. 먼저 데이터의 포맷을 기술한 스키마를 정의한다. 그런 다음 그 스키마를 사용해 새로운 데이터가 올바른 포맷인지 검사하면 된다. (128쪽)
코드를 작성할 때마다 수많은 이름을 선택해야 한다. 변수, 함수, 노트북, 프로젝트, 이 모든 것은 이름이 필요하다. 좋은 이름을 짓는 것은 코드를 가독성 있게 만드는 데 중요한 부분이다. 누군가가 여러분의 코드를 사용하고자 한다면 코드를 변경하기 전에 전체를 훑어볼 것이다. 여러분이 사용하는 이름은 코드가 해야 할 일을 전달할 것이다. 예를 들어 download_and_clean_monthly_data라는 함수 이름이 process_data라는 이름의 함수보다 더 많은 정보를 전달한다. 주피터 노트북 이름을 untitled1.ipynb로 지으면 절대 안 된다. 이 이름은 노트북에 무엇이 담겨 있는지에 대해 어떤 정보도 전달하지 않기 때문이다. 나중에 그 노트북에서 필요한 것이 있더라도, 좋은 이름 없이는 찾을 수 없을 것이다. (155쪽)
이 책을 읽고 어떤 느낌을 받으셨나요?
리뷰를 남기고 다른 독자들과 함께 공유해보세요.
안내 열기구매(배송/수령완료) 후 리뷰를 작성하시면 적립금 300원을 드려요!