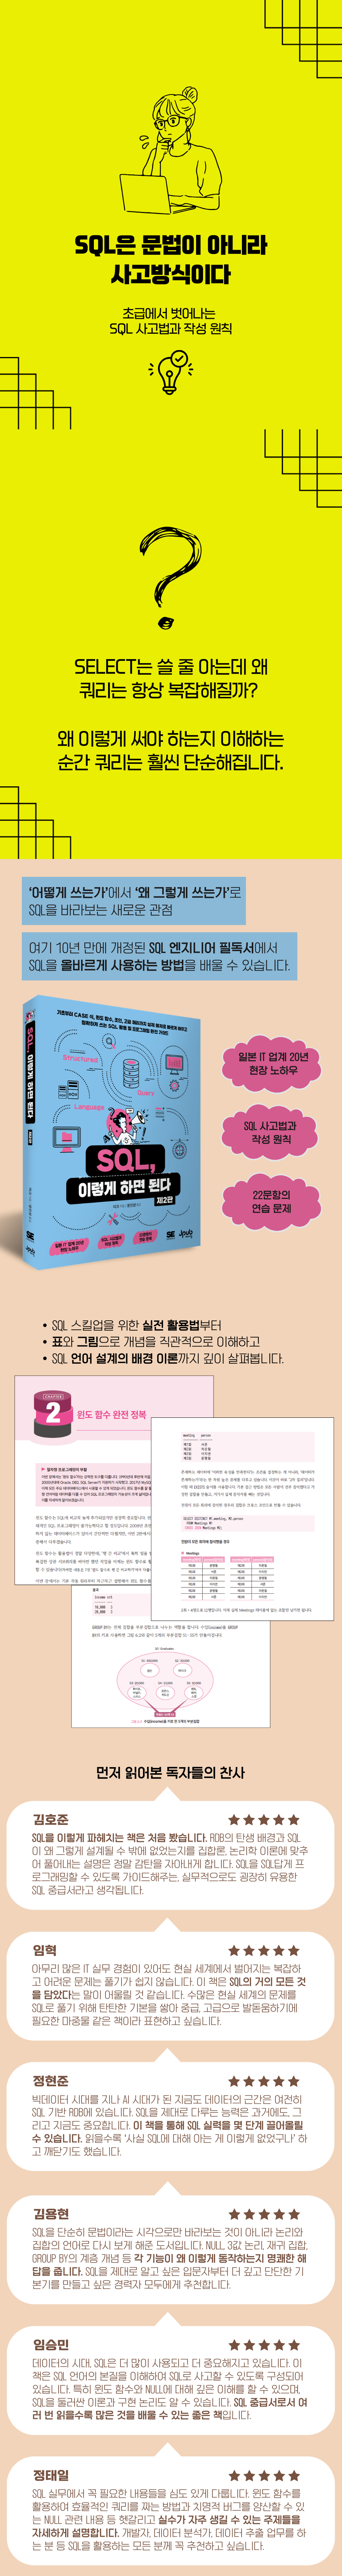
[목 차]
옮긴이 머리말 xiv
베타리더 후기 xvi
머리말 xix
이 책에 대하여 xxii
PART I | SQL이라는 마법
CHAPTER 1 | CASE 식 활용하기 2
1.1 시작하며 2
1.2 CASE 식의 기본 형태 3
1.3 기존 코드를 새로운 체계로 바꿔서 집계하기 5
1.4 서로 다른 조건을 하나의 SQL로 집계하기 9
1.5 CHECK 제약으로 여러 열의 조건 관계 정의하기 13
1.6 조건에 따라 다르게 UPDATE하기 15
1.7 테이블 간 매칭 20
1.8 CASE 식 안에서 집계 함수 사용하기 22
1.9 정리 25
CHAPTER 2 | 윈도 함수 완전 정복 30
2.1 윈도란 무엇인가? 31
2.2 한 장으로 이해하는 윈도 함수 34
2.3 프레임 절로 다른 행의 데이터 가져오기 35
2.4 윈도 함수의 내부 동작 43
2.5 정리 46
CHAPTER 3 | 셀프 조인 활용법 50
3.1 중복순열, 순열, 조합 50
3.2 중복 행 삭제하기 56
3.3 부분적으로 일치하지 않는 키 검색하기 58
3.4 정리 61
CHAPTER 4 | 3값 논리와 NULL 67
4.1 시작하며 67
4.2 이론편 68
4.3 실전편 73
4.4 정리 86
CHAPTER 5 | EXISTS 술어 사용법 93
5.1 이론편 94
5.2 실전편
5.3 정리 113
CHAPTER 6 | HAVING 절의 힘 116
6.1 데이터 누락 찾기 117
6.2 HAVING 절과 서브쿼리: 최빈값 구하기 122
6.3 NULL을 포함하지 않는 집합 찾기 125
6.4 HAVING 절과 보편 양화 132
6.5 유일 집합과 다중 집합 137
6.6 관계 나눗셈으로 장바구니 분석하기 140
6.7 정리 145
CHAPTER 7 | 윈도 함수로 행 간 비교하기 151
7.1 시작하며 151
7.2 성장·감소·현상 유지 152
7.3 시계열에 누락된 연도가 있는 경우: 직전 연도와 비교 157
7.4 윈도 함수 vs 상관 서브쿼리 159
7.5 겹치는 기간 확인하기 164
7.6 정리 169
CHAPTER 8 | 외부 조인 활용법 171
8.1 시작하며 171
8.2 외부 조인으로 행렬 변환 (1): 행→열로 바꿔 크로스 테이블 만들기 172
8.3 외부 조인으로 행렬 변환 (2): 열→행으로 반복되는 항목 정리하기 177
8.4 크로스 테이블로 중첩된 행 구조 만들기 180
8.5 곱셈으로서의 조인 185
8.6 완전 외부 조인 188
8.7 외부 조인으로 집합 연산하기 191
8.8 외부 조인으로 차집합 구하기: A - B 191
8.9 외부 조인으로 차집합 구하기: B - A 192
8.10 완전 외부 조인으로 배타적 합집합 구하기 193
8.11 정리 195
CHAPTER 9 | SQL의 집합 연산 198
9.1 시작하며 198
9.2 집합 연산과 관련된 몇 가지 주의점 199
9.3 테이블끼리 비교하기: 집합의 동일성 확인[기본편] 200
9.4 테이블 비교: 집합의 동일성 확인[응용편] 204
9.5 차집합으로 관계 나눗셈 표현하기 206
9.6 동일한 부분집합 찾기 209
9.7 중복 행을 빠르게 삭제하는 쿼리 213
9.8 정리 215
CHAPTER 10 | SQL로 수열 다루기 218
10.1 시작하며 218
10.2 순번 만들기 219
10.3 누락된 번호 전부 찾기 223
10.4 세 명이 연속으로 앉을 수 있는 좌석 배치 225
10.5 줄바꿈이 있는 수열 229
10.6 단조증가와 단조감소 231
10.7 정리 235
CHAPTER 11 | SQL 빠르게 만들기 238
11.1 시작하며 238
11.2 효율적으로 검색하기 239
11.3 정렬 피하기 241
11.4 극값 함수(MAX/MIN)에서 인덱스 사용하기 245
11.5 WHERE 절에 쓸 수 있는 조건은 HAVING 절에 쓰지 않기 246
11.6 인덱스가 정말 사용되고 있을까? 247
11.7 중간 테이블 줄이기 251
11.8 정리 254
CHAPTER 12 | SQL 프로그래밍 스타일 256
12.1 시작하며 256
12.2 테이블 설계 258
12.3 코딩 스타일 지침 260
12.4 대문자와 소문자 265
12.5 정리 273
PART II | 관계형 데이터베이스의 세계
CHAPTER 13 | RDB 근현대사 276
13.1 관계형 데이터베이스의 역사 276
13.2 파괴적 혁신은 반복될까? 282
13.3 NoSQL의 종류와 해결 방법 284
13.4 성능 문제 해결하기 285
13.5 정리 287
CHAPTER 14 | 왜 ‘관계’ 모델이라고 부를까? 289
14.1 관계의 정의 290
14.2 도메인의 우울 293
14.3 관곗값과 관계 변수 294
14.4 관계 안의 관계가 가능할까? 295
CHAPTER 15 | 관계로 시작해 관계로 끝나다 298
15.1 연산으로 보는 집합 298
15.2 이론과 실제 301
CHAPTER 16 | 주소라는 거대한 괴물 303
16.1 시작하며 304
16.2 주소에서 자유로워지기 위해 태어난 관계 모델 304
16.3 프로그래밍에 넘쳐나는 주소 306
16.4 사라지지 않는 노병: 배커스의 꿈 308
CHAPTER 17 | 순서를 둘러싼 모험 309
17.1 늦게 나타난 주인공 309
17.2 행에 순서가 있어야 할까? 309
CHAPTER 18 | GROUP BY와 PARTITION BY 315
18.1 차이점을 아시나요? 315
CHAPTER 19 | 절차형에서 선언형·집합 지향으로 사고 전환을 위한 7가지 원칙 321
19.1 IF 문과 CASE 문을 CASE 식으로 바꾸기: SQL은 함수형 언어와 비슷하다 322
19.2 반복문을 GROUP BY 절과 윈도 함수로 바꾸기 324
19.3 테이블 행에는 순서가 없음을 기억하기 324
19.4 테이블을 집합으로 보기 326
19.5 EXISTS 술어와 ‘양화’ 개념 이해하기 326
19.6 HAVING 절의 진짜 가치 알아보기 327
19.7 네모 말고 원 그리기 328
CHAPTER 20 | 신이 사라진 세상의 논리 330
20.1 때로는 참과 거짓을 포기하라 330
20.2 논리학의 혁명 332
20.3 인간을 위한 논리 333
CHAPTER 21 | SQL과 재귀 집합 335
21.1 실무에서 만나는 재귀 집합 335
21.2 노이만의 선배들 336
21.3 수란 무엇인가? 338
21.4 SQL의 마술과 과학 341
CHAPTER 22 | NULL 박멸 위원회 342
22.1 결의문: 모든 DB 엔지니어에게 고함 342
22.2 왜 NULL이 그렇게 나쁠까? 343
22.3 하지만 NULL을 완전히 없앨 수는 없다 344
22.4 코드의 경우: 대체 코드 만들기 346
22.5 이름의 경우: 기본값 정하기 347
22.6 숫자의 경우: 0으로 바꾸기 347
22.7 날짜의 경우: 최댓값·최솟값 사용하기 348
22.8 지침 정리 348
CHAPTER 23 | SQL의 존재 계층 349
23.1 술어 논리의 계층과 집합의 계층 349
23.2 집계하면 왜 원래 열을 참조할 수 없을까? 350
23.3 원소 하나짜리 집합도 엄연한 집합이다 354
PART III | 부록
APPENDIX A | 연습 문제 해답 358
맺음말 386
찾아보기 390
[본 문]
단순하게 생각하면 다음과 같이 UPDATE 문을 두 번 실행하면 될 것 같지만, 이는 잘못된 방법입니다. (…) 왜 잘못된 방법일까요? 예를 들어 현재 급여가 300만 원인 직원의 경우, 조건 1의 UPDATE로 급여가 270만 원으로 줄어듭니다. 하지만 여기서 끝이 아닙니다. 이어서 실행되는 조건 2의 UPDATE에 의해 324만 원으로 다시 늘어나버립니다. 감봉인 줄 알았는데 실제로는 24만 원이 인상된 셈입니다. (27쪽)
Lisp, Haskell 같은 함수형 언어 또는 자바를 써보신 분이라면 ‘고차 함수’라는 개념을 아실 겁니다. 일반 값이 아니라 함수를 인수로 받는 함수를 말합니다. 이때 ‘차수’도 술어 논리의 ‘차수’와 같은 개념입니다(사실 차수라는 개념 자체가 집합론과 술어 논리에서 나왔습니다). EXISTS는 집합이라는 1차 존재를 인수로 받으므로 2차 술어가 되고, 술어는 함수의 일종이므로 결국 다음과 같이 말할 수 있습니다. EXISTS는 고차 함수이다. (97쪽)
상관 서브쿼리를 윈도 함수로 대체할 수 있다는 걸 확인했는데, 근본적인 질문을 해보겠습니다. 왜 윈도 함수로 상관 서브쿼리를 대체할 수 있을까요? 두 방식의 문법은 전혀 다른데 말입니다. /
‘바꿔봤더니 같은 결과가 나왔으니까’라고 하면 맞는 말이지만, 사실 두 방식이 비슷한 기능을 한다는 건 동작을 자세히 보면 그리 놀랍지 않습니다. 핵심은 집합(테이블)을 ‘나누는’ 방식에 있습니다. / 이를 확인하기 위해 다음과 같은 상품 정보 테이블을 사용해보겠습니다. (160쪽)
IN 술어는 편리하고 이해하기 쉬워서 매우 자주 사용됩니다. 하지만 성능적으로 병목이 될 위험도 있습니다. 자주 사용하는 만큼 IN 술어 사용법만 개선해도 성능이 극적으로 향상되는 경우가 많습니다. / IN의 인수로 (1, 2, 3) 같은 값 목록을 사용할 때는 괜찮지만, 서브쿼리를 인수로 사용할 때는 주의가 필요합니다. NOT IN과 NOT EXISTS는 대부분 동일한 결과를 반환하지만, 서브쿼리를 사용할 때는 EXISTS가 훨씬 빠릅니다. / 지금까지 여러 번 사용했던 두 수강 클래스 테이블로 예를 들어보겠습니다. (239쪽)
관계형 데이터베이스에는 프로그래밍에서 흔히 ‘포인터’라고 부르는 물리적 위치 정보가 없습니다. (…) SQL과 RDB는 데이터를 최대한 추상적으로 표현하고, 물리적 구현을 사용자가 신경 쓰지 않도록 설계되었기 때문입니다. / 그런데 이 때문에 C 언어 등에서 포인터를 자유롭게 다루던 프로그래머들이 SQL을 어색하게 느끼는 경우가 많습니다. ‘SQL은 포인터를 못 써서 불편하고 문제가 있다’는 엉뚱한 비판을 하기도 합니다. / 이번 장에서는 SQL의 기본 설계 철학을 ‘주소로부터의 해방’이라는 관점에서 살펴보고, 절차적 언어에 익숙한 프로그래머가 SQL을 불편하게 느끼는 이유를 알아보겠습니다. (304쪽)
이 책을 읽고 어떤 느낌을 받으셨나요?
리뷰를 남기고 다른 독자들과 함께 공유해보세요.
안내 열기구매(배송/수령완료) 후 리뷰를 작성하시면 적립금 300원을 드려요!